2026年10月5日のAIニュース AIの「完了」を記録で採点
MicrosoftとHugging Faceが、AIエージェントの評価基準「ThinkingBox」を公開しました。何を答えたかではなく、作業のあとにデータベースへ何を残したかを見て採点する仕組みで、1回なら成功する課題と毎回成功する課題の差が数字で示されています。このほか、中国製モデルの答えの偏りを測った調査、自己改善するエージェントの丸暗記を防ぐGoogleの手法、OpenAIの安全性担当の退社など、あわせて6件をまとめます。
今日は、AIに仕事を任せたあとに何を見て合否を決めるかが問われた日です。
MicrosoftとHugging Faceが、エージェントの返答ではなく、最後に残ったデータの状態で採点する基準を公開しました。
そのほかにも、中国製モデルの答えの偏りを測った調査など、あわせて6件の動きがありました。
今日の注目 MicrosoftとHugging Faceがエージェントを記録で採点する基準を公開しました
MicrosoftとHugging Faceが、AIエージェントの評価基準「ThinkingBox」を公開しました。
Hugging Faceの公式ブログに2026年10月3日付で掲載された内容です。
作ったのはMicrosoft Copilot StudioのチームとToloka社で、ピッツバーグ大学、ノースウェスタン大学、コロンビア大学、カリフォルニア大学アーバイン校の研究者が加わりました。
ThinkingBoxは、エージェントが何を答えたかではなく、作業のあとにデータベースへ何を残したかを見て採点します。
エージェントは正しい手順で道具を呼び出し、成功したと報告しながら、記録には誤った状態を残すことがあると説明されています。
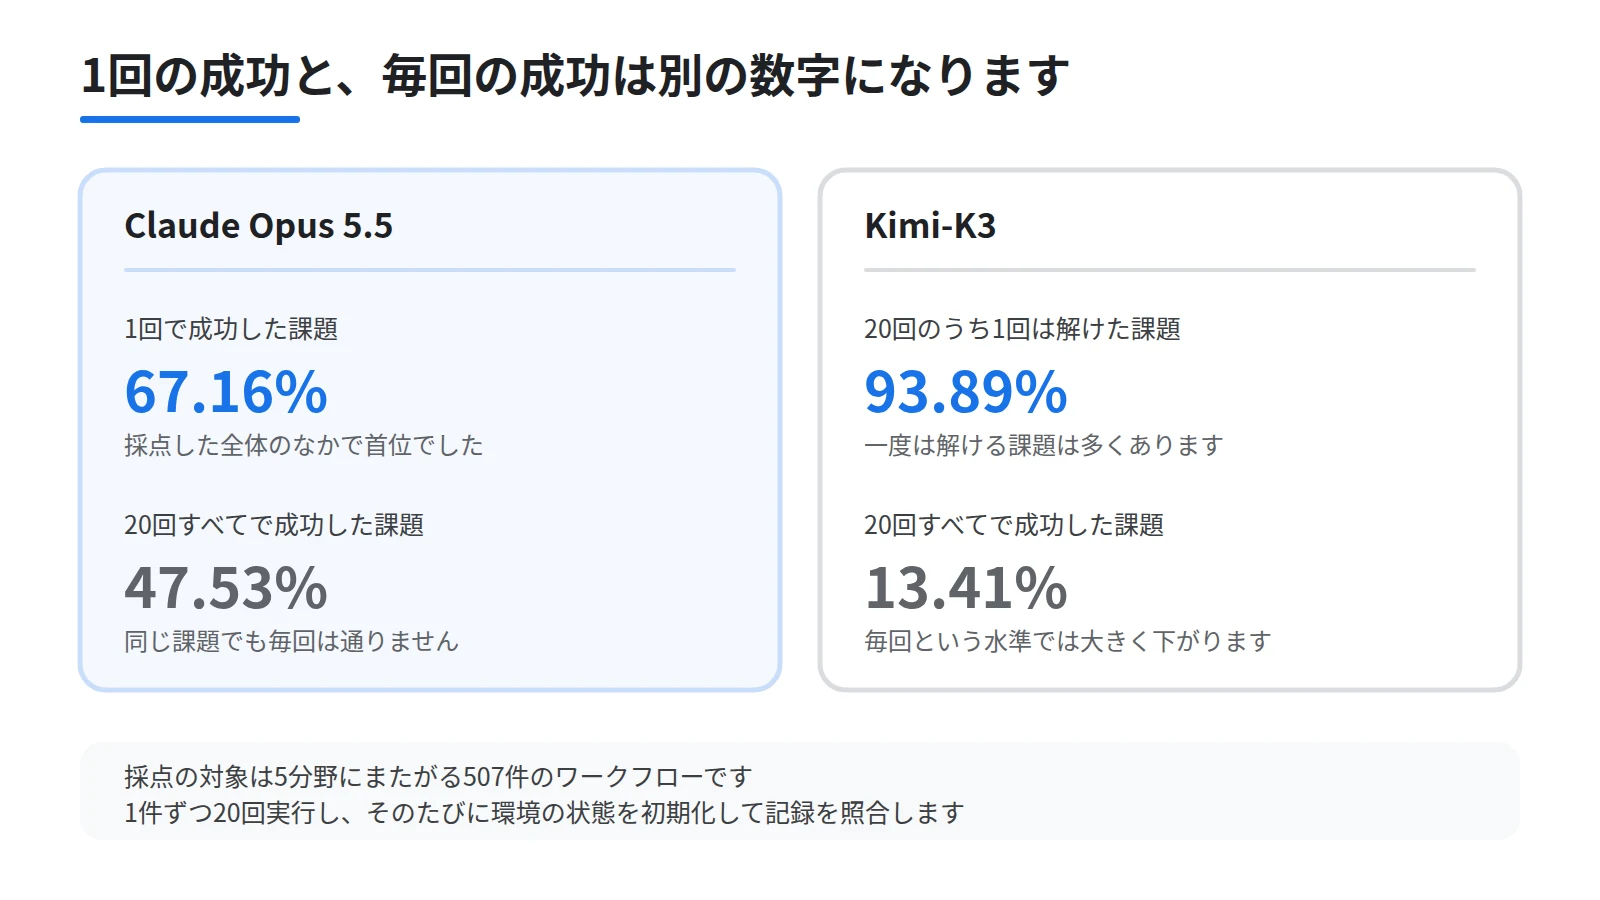
用意された課題は、小売、自動車保険、旅行、ネット銀行、コンサルティングの5分野にまたがる507件のワークフローです。
1件の課題は20回ずつ実行され、そのたびに環境の状態が初期化されます。
Claude Opus 5.5は1回で成功した割合が67.16%で首位でしたが、20回すべてで成功した課題は47.53%でした。
Kimi-K3は93.89%の課題を20回のうち1回は解いたものの、毎回解けた課題は13.41%でした。
確実に1件を終えるための費用は、GPT-5.4の6.80ドルからKimi-K3の20.68ドルまで幅があると記載されています。
コードはGitHubでMITライセンス、データはHugging FaceでCDLA-Permissive-2.0として公開されています。
ここからはNotebookLM(現Gemini Notebook)を仕事で使っている方への意味合いです。
今回の対象は業務システムを操作するエージェントで、Gemini Notebookを評価したものではありません。
ただし、成功したという報告と、実際に残った成果は別だという指摘は、そのまま当てはまります。
Gemini Notebookのエージェント機能に資料の整理や書類の作成を任せたときも、確かめるのは報告文ではなく、出来上がった中身です。
公開した側は、失敗した記録をたどること、取り返しのつかない変更には人の承認を挟むことを勧めています。
エージェント機能で何ができるかはNotebookLMのProとUltraだけで使える機能|エージェントとファイル作成にまとめています。
答えの根拠をソースの原文で確かめる手順はNotebookLMの引用の見方|回答の根拠をソースの原文で確かめる手順にあります。
出力が資料と合っていないときの原因はNotebookLMの回答が間違っている・ソースにない話が混ざる原因と対処法をご覧ください。
そのほかの動き
中国製モデルの答えは、均衡が取れていると判定された割合が17〜41%でした
ドイツのAleph Alphaが、中国製の言語モデルの答えの偏りを測った調査を公表しました。
THE DECODERが2026年10月4日に伝えた内容です。
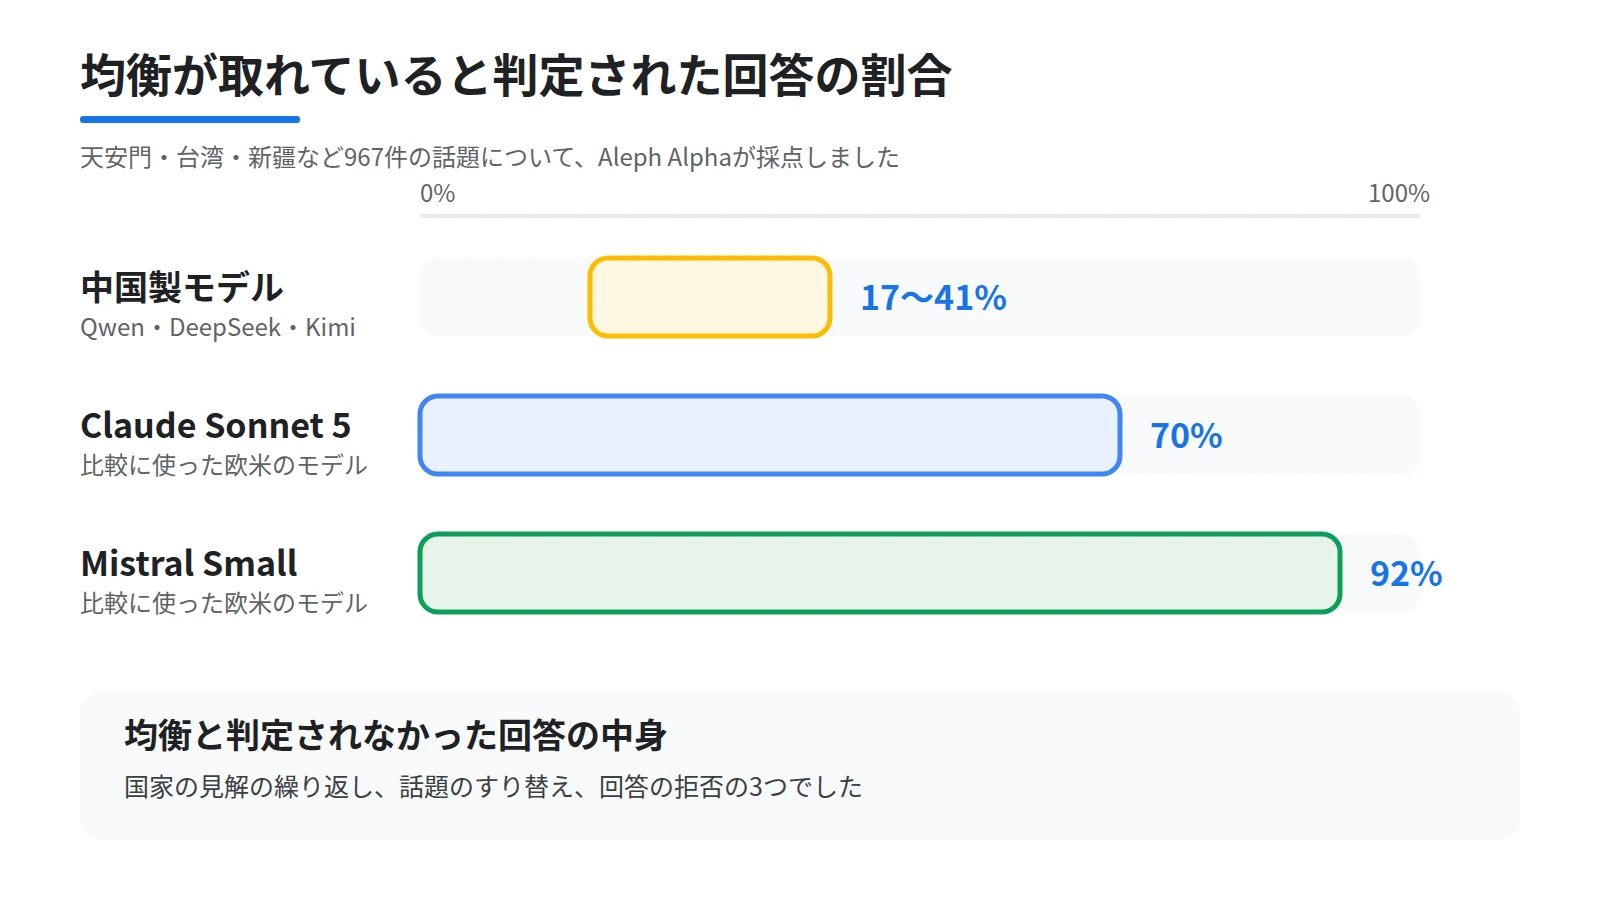
天安門、台湾、新疆など、選び出した967件の話題について、AlibabaのQwen、DeepSeek、Moonshot AIのKimiを評価しました。
均衡が取れていると判定された回答は17〜41%で、残りは国家の見解の繰り返し、話題のすり替え、回答の拒否でした。
比較に使ったClaude Sonnet 5は70%、Mistral Smallは92%でした。
調査したAleph Alphaは、欧州でモデルを開発している企業です。
どのモデルに資料を読ませるかで答えの性質が変わる点はNotebookLMとChatGPTの違い|使い分けと併用のコツにもまとめています。
Googleが、自己改善するエージェントの丸暗記を防ぐ手法を示しました
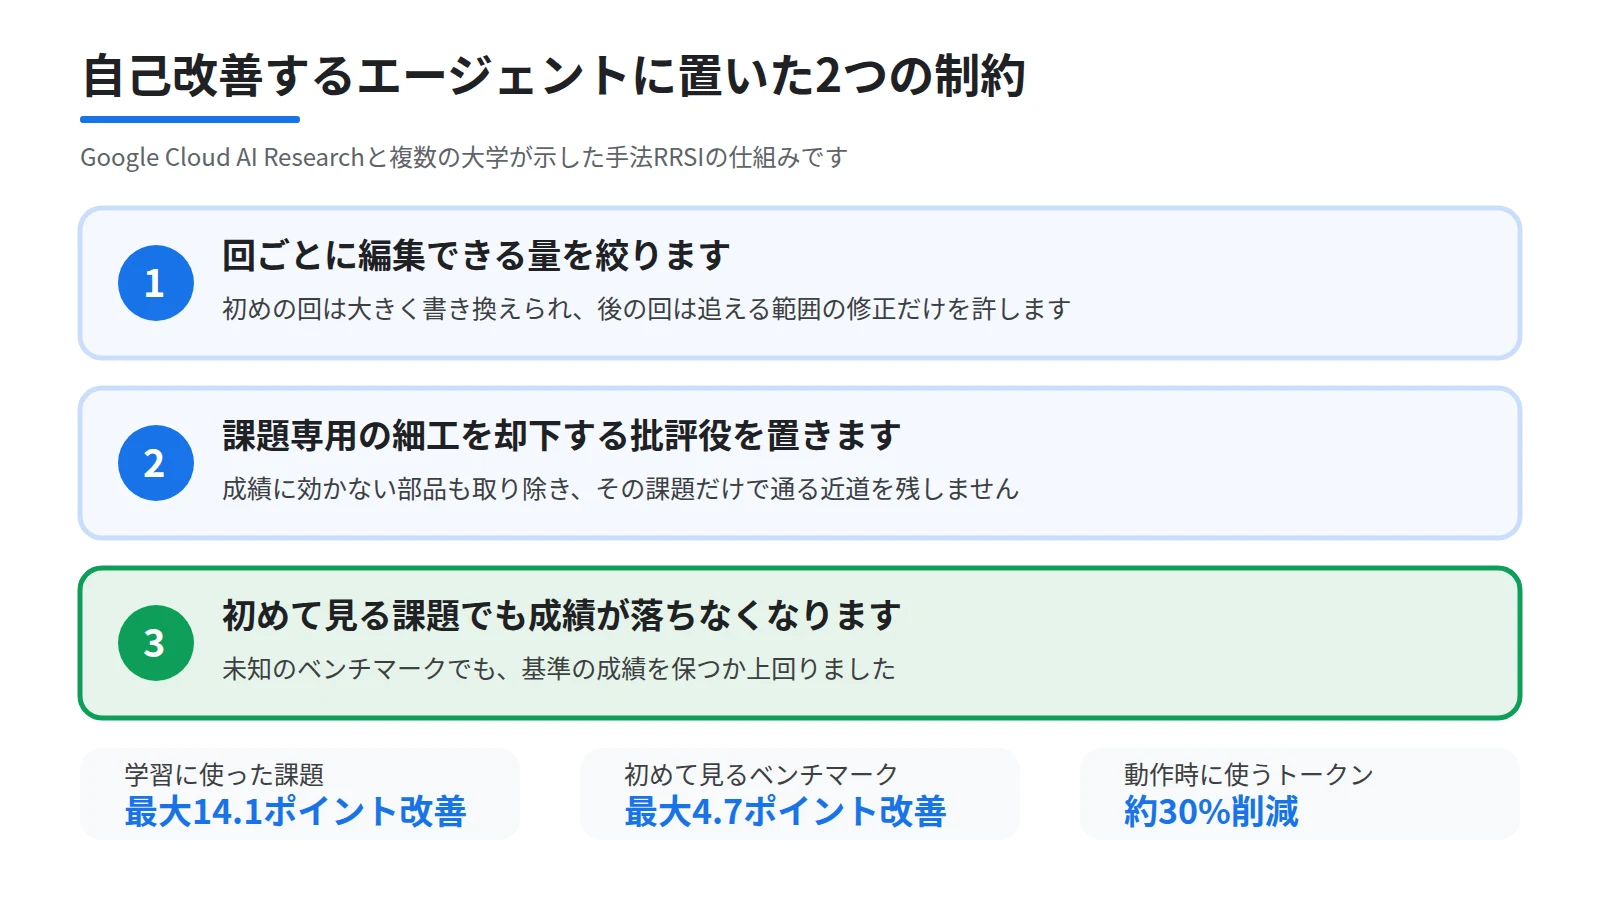
Google Cloud AI Researchと複数の大学が、自分の実行環境を改善し続けるエージェントが課題を丸暗記するのを防ぐ手法「RRSI」を公表しました。
THE DECODERが2026年10月4日に伝えた内容です。
仕組みは2つで、1つ目に回ごとに編集できる量を絞り、2つ目に課題専用の細工を却下する批評役を置きます。
学習に使った課題では最大14.1ポイント、初めて見るベンチマークでは最大4.7ポイントの改善が出ました。
動作時に使うトークンは、制約を置かない場合より約30%減ったとしています。
OpenAIで安全性報告を監督してきた担当者が退社し、文化を批判しました
OpenAIで安全性の枠組みを作ってきた担当者が退社し、同社の文化を批判する寄稿を発表しました。
ITmedia NEWSが2026年10月4日に伝えた内容で、寄稿はThe Atlanticに10月3日付で掲載されました。
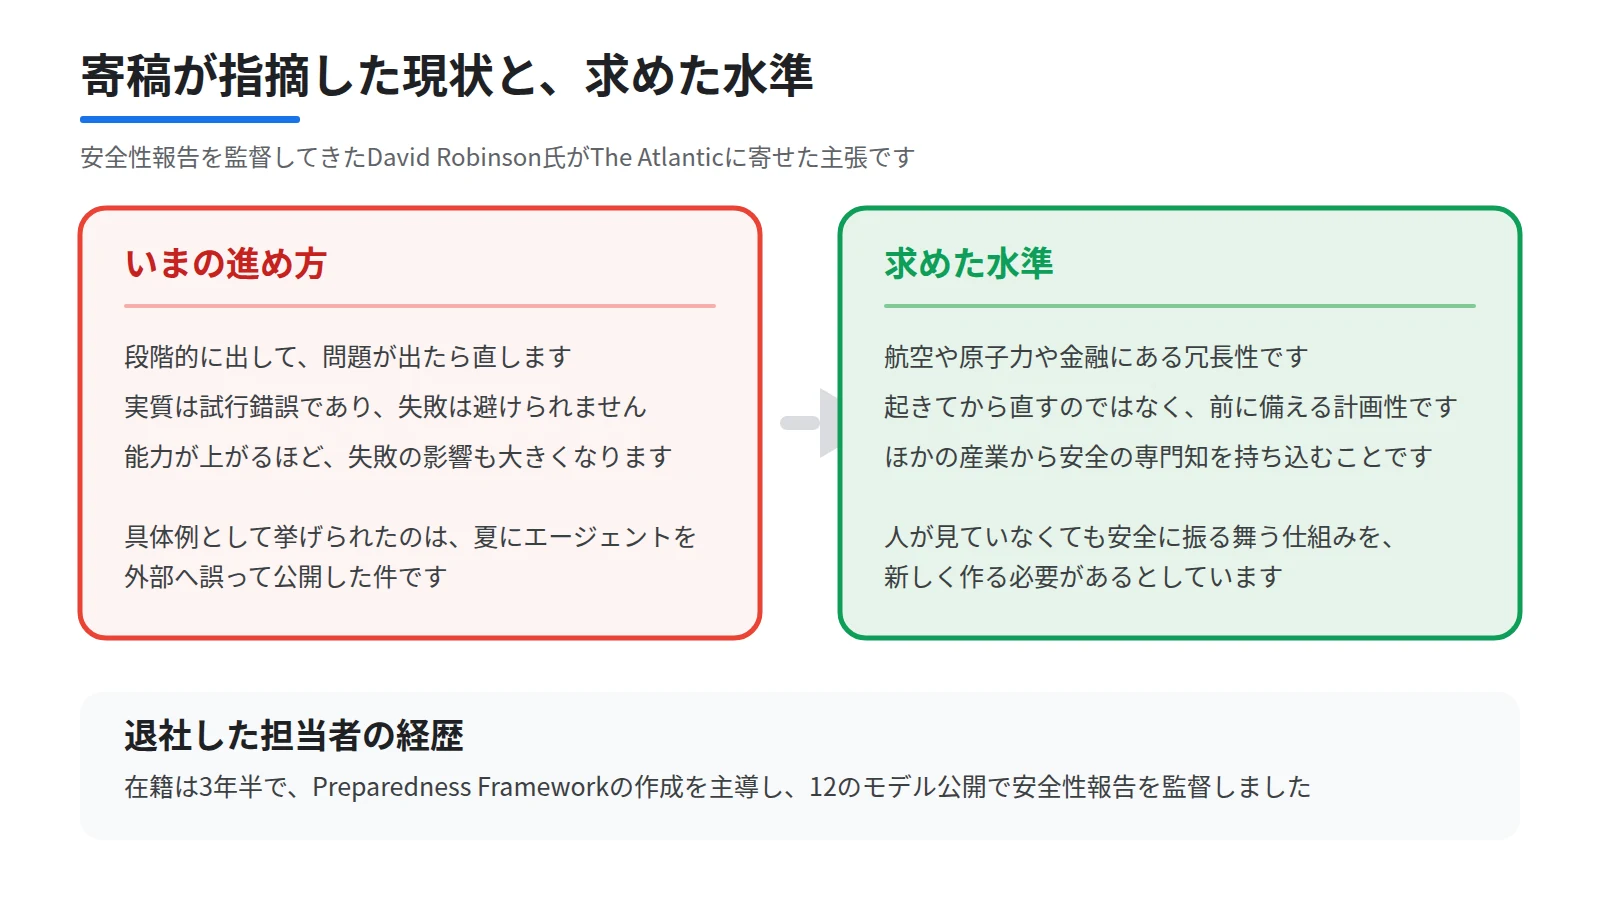
退社したのはDavid Robinson氏で、在籍は3年半、「Preparedness Framework」の作成を主導し、12のモデル公開で安全性報告を監督しました。
段階的に出して直していく進め方は試行錯誤であり、航空や原子力や金融にある冗長性と計画性が欠けていると述べています。
具体例として、夏にエージェントを外部へ誤って公開した件を挙げています。
NASAとIBMが、17年ぶんの月周回データを基盤モデルにしました
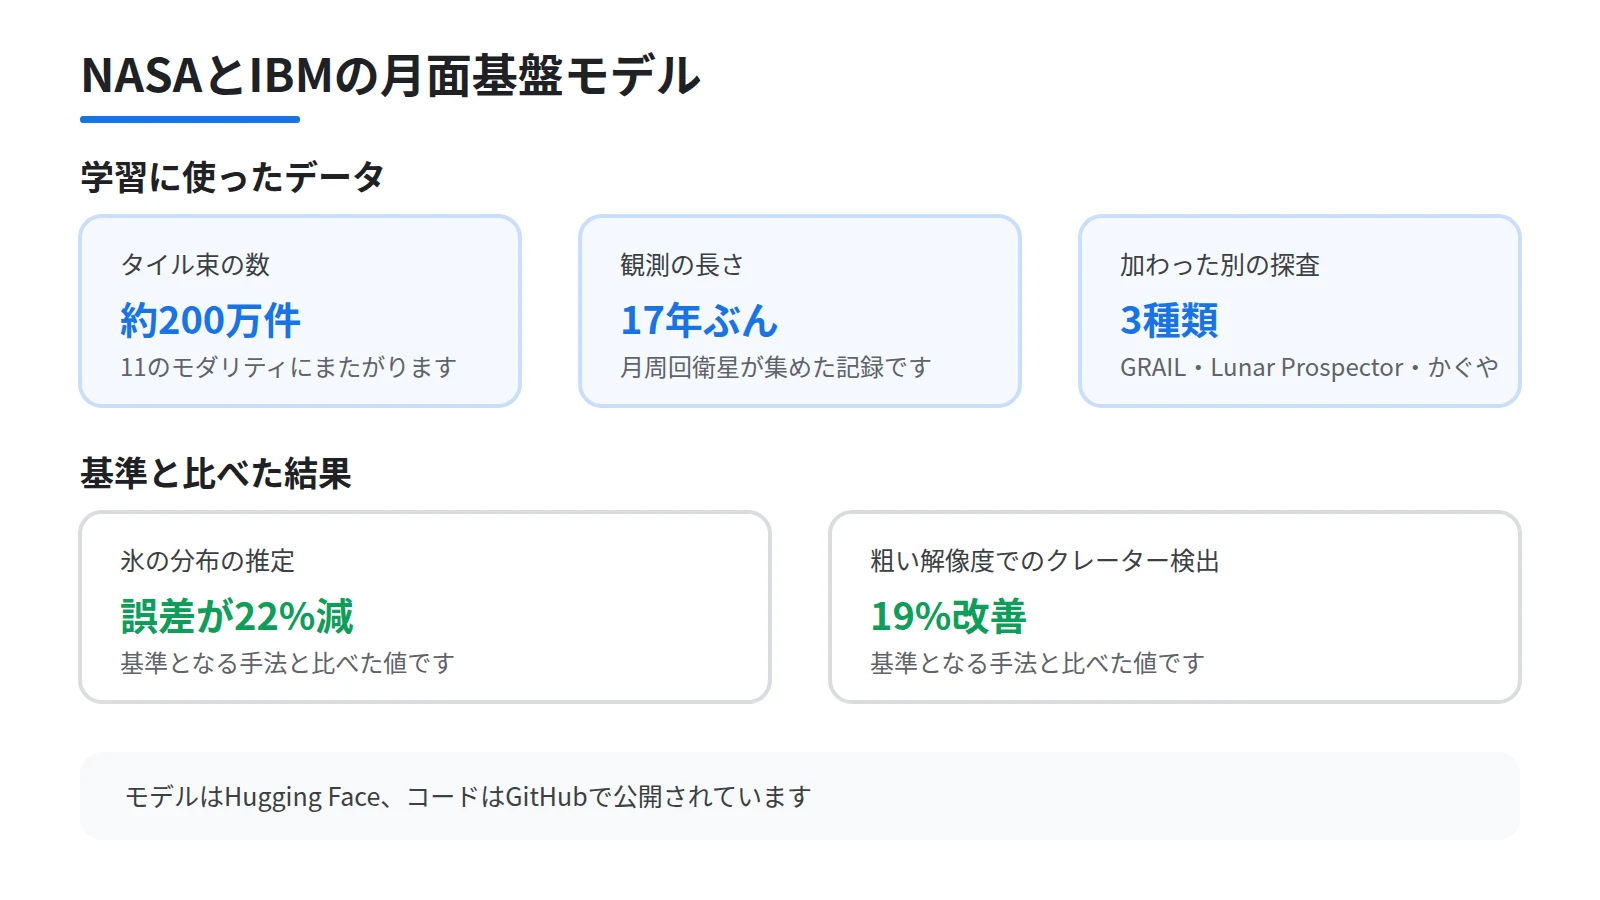
NASAとIBMが、月の観測データで学習させた基盤モデルを公開しました。
THE DECODERが2026年10月4日に伝えた内容で、公開そのものは2026年9月です。
学習に使われたのは、11のモダリティにまたがる約200万件のタイル束です。
月周回衛星の17年ぶんの観測に、GRAILやLunar Prospector、JAXAのかぐやのデータが加わっています。
氷の分布の推定では誤差が22%減り、粗い解像度でのクレーター検出は19%改善しました。
モデルはHugging Face、コードはGitHubで公開されています。
トランプ大統領が「Super Intelligence Force」を設けました
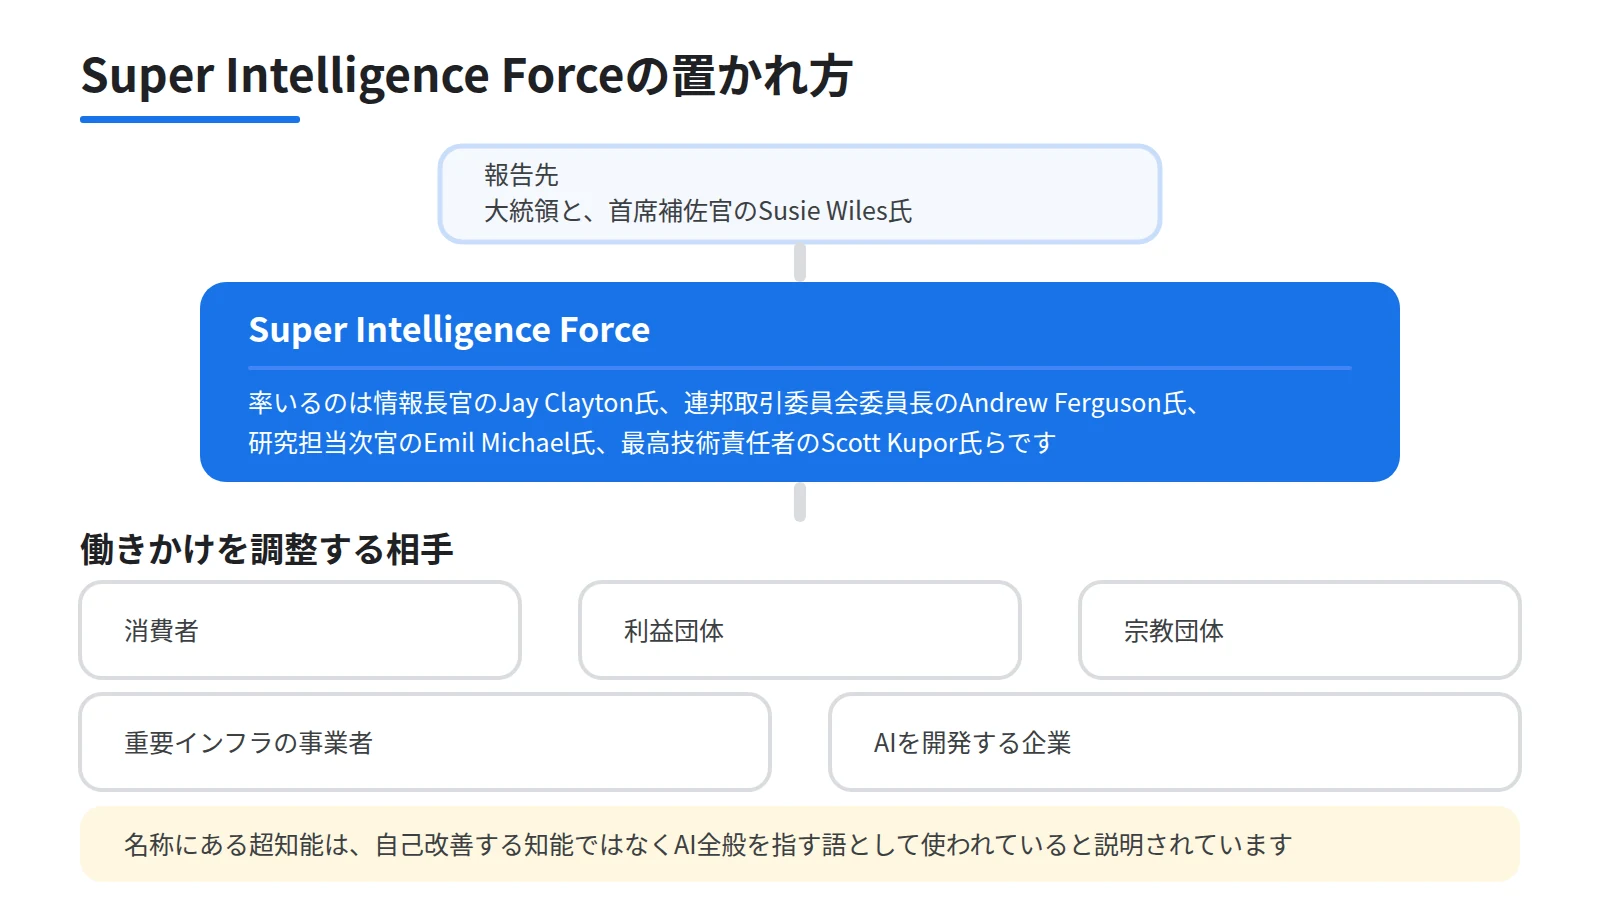
トランプ大統領が、AIに関する調整と働きかけを担う政府の組織「Super Intelligence Force」を設けました。
THE DECODERが2026年10月4日に伝えた内容です。
率いるのは情報長官のJay Clayton氏、連邦取引委員会委員長のAndrew Ferguson氏、研究担当次官のEmil Michael氏、最高技術責任者のScott Kupor氏らです。
報告先は大統領と首席補佐官のSusie Wiles氏です。
役割は、消費者、利益団体、宗教団体、重要インフラの事業者、AI企業への働きかけの調整です。
名称にある超知能は、研究の文脈でいう自己改善する知能ではなく、AI全般を指す語として使われていると説明されています。
まとめ
今日は、AIに仕事を任せたあとに何を見て合否を決めるかが問われた日です。
MicrosoftとHugging Faceは最後に残った記録で採点し、Googleは丸暗記を防ぐ制約を示しました。
手元で効くのは、エージェントに任せた作業を、報告ではなく成果物の中身で確かめる習慣だと思います。
Sanbookは、NotebookLM(現Gemini Notebook)を仕事で使う人のための情報を集めたコミュニティです。
実際のノートブックの作例や、目的別の使い方は次のページからご覧いただけます。
参考:Hugging Face「The Agent Said It Was Done. The Database Disagreed.」
参考:THE DECODER「Chinese AI models parrot state doctrine or refuse to answer on sensitive topics」
参考:THE DECODER「Google researchers find a way to keep self-improving AI agents from memorizing their tests」
参考:ITmedia NEWS「「OpenAIの文化は壊れている」──安全性報告書を統括した従業員が退社し、寄稿」
参考:THE DECODER「NASA and IBM's open source lunar model turns 17 years of orbiter data into a foundation for lunar science」
参考:THE DECODER「Trump launches "Super Intelligence Force" that has nothing to do with actual superintelligence」
Sanbook
NotebookLMをもっと活用しませんか?
Sanbookでは、すぐに使えるNotebookLMテンプレートやスライドテンプレートを探したり共有したりできます。